Содержаниеразделов: 9
- Из чего вообще складывается цена голосового робота?
- Сколько стоит голосовой робот в облаке?
- Что меняется в цене, если данные должны остаться у вас?
- Сколько стоит железо, если наружу не уходит ничего?
- Почему нельзя сэкономить на железе?
- Можно ли сначала арендовать, а потом покупать?
- Какой вариант выбрать?
- Кому такое внедрение не подходит?
- Что ещё войдёт в счёт, кроме сервера?
До покупкиЗАМЕТКА
Сколько стоит голосовой робот: облако, свой контур и своё железо
Цена голосового робота складывается по-разному в трёх вариантах поставки: поминутно в облаке, сервер без GPU плюс минуты, когда данные у вас, и серверы с GPU, когда наружу не уходит ничего. Разбираем бюджет каждого варианта, почему дешёвое железо не тянет и почему сначала арендуют, а потом покупают.
Costa10 мин чтения
Короткий ответ
Цена голосового робота зависит от того, где работают модели. В облаке вы платите за минуты разговора и не покупаете железо. Если данные должны остаться у вас, добавляется обычный сервер без GPU. Если наружу не может уходить ничего, нужны серверы с GPU: для 20-30 одновременных разговоров ориентир - два L40S за $35-50 тыс. по ценам на 9 октября 2026 года. Внедрение под ключ мы оцениваем в $25-40 тыс. за первую рабочую версию плюс $1,5-3 тыс. в месяц на сопровождение.
Ключевые факты
- Внедрение голосового оператора под ключ (Asterisk, телефония, ИИ-оператор, интеграция, запуск): первая рабочая версия $25-40 тыс., сопровождение $1,5-3 тыс. в месяц; железо, связь и лицензии считаются отдельно.
- Ориентировочные цены сервера на 9 октября 2026 года: пилот на одной карте $20-35 тыс., база 2 × L40S $35-50 тыс., 2 × RTX PRO 6000 $45-60 тыс., 4 × L40S $55-75 тыс., 4 × H200 NVL $160-200 тыс., б/у A100 80 ГБ $8-12 тыс. за карту.
- Аренда 2 × L40S по требованию на 730 часов стоила от ≈ $790 в месяц на Vast.ai до ≈ $2 720 на AWS g6e, цены проверены 9 октября 2026 года.
- Речевой конвейер агентов ElevenLabs на 9 октября 2026 года стоил $0,080 за минуту сверх пакета.
- Число разговоров для каждой конфигурации - допущение, которое подтверждается нагрузочным тестом с вашими сценариями, а не замер.
Запрос «голосовой робот цена» в выдаче обычно получает прайс одной платформы: столько-то рублей за минуту или пакет минут на квартал. Это честная цена, но за одну конкретную покупку. На деле цена голосового робота складывается из разных счетов в зависимости от того, где работают модели: поминутно в облаке, обычный сервер плюс минуты, когда данные должны оставаться у вас, и серверы с GPU, когда наружу не может уходить ничего. Ниже по каждому варианту то, что мы считаем сами, с датами и источниками.
Коротко: для 20-30 одновременных разговоров первую рабочую версию под ключ мы оцениваем в $25-40 тыс., сопровождение в $1,5-3 тыс. в месяц. Железо, связь и лицензии считаются отдельно, и именно в железе разница между вариантами бывает больше, чем всё внедрение целиком.
Из чего вообще складывается цена голосового робота?
Голосовой робот - не одна программа. Это цепочка, которая работает в реальном времени на каждом звонке, и на странице поставки перечислены её звенья: телефония, распознавание речи, языковая модель, которая решает, что сказать, синтез голоса, который это произносит, и интеграции, которые записывают результат туда, где с ним работают.
За каждое звено кто-то платит. Телефония - это SIP-транк и номера, их счёт приходит от оператора связи в любом варианте. Три модели в середине оплачиваются либо поминутно у провайдера, либо один раз в виде железа, на котором они живут. Интеграции и сценарии - это работа: промпт, знания, проверки и тесты на каждый сценарий. И сопровождение, потому что сценарии меняются вместе с прайсом и расписанием, а разговоры кто-то должен слушать.
Поэтому прежде чем сравнивать цены, полезно ответить на вопрос, на который поминутный прайс не отвечает: где должны работать модели и где должны лежать записи звонков.
Сколько стоит голосовой робот в облаке?
Облако - вариант, на котором работает наше демо: модели у провайдеров речи и языковых моделей, железо не нужно, срок до первой версии самый короткий, голос и задержка такие, как вы слышите в звонке.
Платите вы за минуты. Для ориентира две цены с публичных страниц, проверенные 9 октября 2026 года. Речевой конвейер агентов ElevenLabs стоил $0,080 за минуту сверх пакета; на странице не сказано, входит ли в эту ставку языковая модель, поэтому её и связь закладывайте отдельно. Российская платформа robo-voice.ru продавала пакет на 2 000 минут за 11 800 ₽ со сроком действия три месяца, то есть около 5,9 ₽ за минуту по нашему делению.
Эти две цифры нельзя сравнивать между собой напрямую, и обе нельзя сравнивать с внедрением. Пакет минут на платформе - доступ к конструктору, в котором сценарий собираете вы сами. Ставка за речевой конвейер - один из нескольких счетов, из которых складывается облачный оператор. Внедрение под ключ - это сценарии, интеграция с вашей CRM или учётной системой, критерии приёмки и человек, который отвечает, если что-то сломалось.
В облачном варианте счёт растёт с минутами, а не с пиком. Сто звонков в день по три минуты - примерно 9 000 минут в месяц, и при ставке $0,08 речевая часть стоит около $720 в месяц. Это арифметика, а не предложение: подставьте свои минуты и добавьте модель и связь.
Что меняется в цене, если данные должны остаться у вас?
Тогда появляется средний вариант: телефония, управление разговором, интеграции и записи живут на вашем сервере, а модели вызываются по API. Провайдеру уходит только то, что нужно для ответа, а записи, расшифровки и карточки звонков остаются у вас.
Для этого варианта нужен обычный сервер без GPU, а минуты моделей оплачиваются так же, как в облаке. Голос и задержка остаются такими, как в демо, потому что модели те же. Срок до первой версии средний: кроме сценариев, нужно развернуть и подключить контур у вас.
Это самый частый ответ на требование «данные у нас», и он заметно дешевле полностью локального варианта. Проверьте с юристами, разрешает ли ваша политика обращение к внешним моделям из контура. Если да, железо с GPU покупать не нужно.
Сколько стоит железо, если наружу не уходит ничего?
Полностью локальный вариант - вся цепочка на ваших серверах. Поминутного счёта за модели нет, зато есть сервер с GPU, и его считают по двум вещам сразу.
По памяти, потому что распознавание, языковая модель, синтез и рабочее состояние каждого живого разговора должны поместиться на картах одновременно. И по моменту, когда несколько звонящих договорили фразу в одну и ту же секунду: тогда модель получает пять или десять запросов на первое предложение разом, и если карта занята, опаздывают все. Число звонков в день почти ничего не говорит ни о том, ни о другом.
Вот конфигурации с нашей страницы поставки. Цены сервера оценены 9 октября 2026 года по объявлениям на карты, память и шасси. Это ориентиры, а не коммерческие предложения, и память за 2026 год сильно подорожала.
| Конфигурация | Разговоров одновременно (допущение) | Сервер целиком |
|---|---|---|
| Пилот: 1 × L40S 48 ГБ или 1 × RTX PRO 6000 96 ГБ | 5-10 / 10-20 | $20-35 тыс. |
| База: 2 × L40S, 32 ядра, 256 ГБ, NVMe 2 ТБ | 20-30 | $35-50 тыс. |
| База с запасом: 2 × RTX PRO 6000 96 ГБ | 30-50 | $45-60 тыс. |
| Большой: 4 × L40S или 4 × H200 NVL | 50-100+ | $55-75 тыс. / $160-200 тыс. |
| Бюджетно, б/у: A100 80 ГБ | 15-25 на 2 карты | $8-12 тыс. за карту |
База рассчитана на компактную разговорную модель на 7-14 млрд параметров. Модели на 30-70 млрд нужна третья строка даже при том же числе звонков. Б/у A100 - реальный вариант при жёстком бюджете, но рядом с ценой надо записать две оговорки: нет FP8, а гарантия короткая или её нет.
Каждое число в средней колонке - допущение. Оно зависит от моделей, на которых вы в итоге остановитесь, и до покупки его заменяет измеренное. Голос и задержку в этом варианте тоже проверяют заново: локальные модели звучат и отвечают не так, как облачные, и куда уходит секунда ответа на вашем железе, придётся замерить.
Почему нельзя сэкономить на железе?
Три способа сэкономить приходят в голову первыми, и каждый работает на столе, но не на линии.
Игровая видеокарта. В стойке у неё четыре проблемы. Памяти меньше, чем у серверной карты, поэтому модель покрупнее или больше звонящих не помещаются. Нет памяти с ECC, а это важно для коробки, которая работает каждый день без присмотра. Охлаждение и питание рассчитаны на корпус-башню, а не на плотное серверное шасси в помещении, где ничего не выключают. И лицензия: условия драйвера GeForce от NVIDIA не разрешают установку в дата-центре, и юристы спросят об этом за неделю до запуска, а не за неделю до покупки.
Сервер без GPU. Хорошая коробка для среднего варианта, где модели вызываются по API. Как дом для самих моделей он слишком медленный: пауза в три секунды после каждой фразы ломает разговор, даже если звонят двое.
Самая маленькая облачная карта. Арендовать одну карту - разумный способ начать пилот. Ошибка в том, чтобы считать результат пилота результатом боевой работы. Одна карта, которая отвечает одному тестировщику быстрее секунды, может заметно опаздывать с ответом десяти звонящим, которые договорили одновременно, и разница видна только под нагрузкой.
Сэкономленные на железе деньги потом тратятся на разговоры, в которых робот молчит слишком долго. Звонящий не знает, что сервер занят. Он слышит паузу и решает, что его не поняли.
Можно ли сначала арендовать, а потом покупать?
Можно, и мы советуем именно так. За 2 × L40S по требованию, 730 часов в месяц, цены на 9 октября 2026 года шли от ≈ $790 в месяц на Vast.ai, маркетплейсе частных хостов с плавающим наличием, через ≈ $1 150-1 590 на Runpod и ≈ €2 150 на Scaleway до ≈ $2 720 на AWS, где нет размера на две карты и его собирают из двух инстансов по одной. CoreWeave продаёт только узлы по восемь карт.
Если данные должны оставаться в России, в открытых прайсах, которые мы смотрели, L40S нет вовсе: ближайшее с публичной ценой - 2 × A100 в Immers.cloud примерно за 321 000 ₽ в месяц, а Selectel, Yandex Cloud, Cloud.ru, Timeweb и MTS Cloud называют цену на свои карты по запросу.
Месяц аренды стоит небольшую долю коробки, и за эти деньги вы получаете единственное число, которое имеет значение: как ведёт себя цепочка, когда приходит ваш пик. Порядок у нас короткий. Собираем связку на арендованных картах. Гоняем нагрузочные тесты с вашими сценариями и реальным пиком. По результатам фиксируем требования к серверу. Только после этого покупаем.
В России этот порядок важен вдвойне: те же карты стоят примерно в 1,5-2 раза дороже и обычно идут под заказ со сроком 40-60 рабочих дней. Ошибка в закупке там стоит квартал, а не возврат.
Какой вариант выбрать?
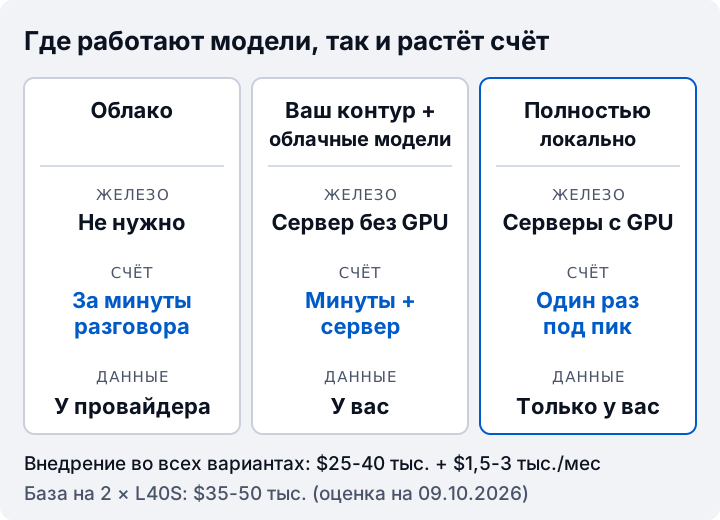
Правило простое. Если записи звонков у провайдера допустимы, берите облако: оно быстрее и дешевле на старте. Если данные должны оставаться у вас, но обращение к внешним моделям по API разрешено, берите свой контур с облачными моделями и сервер без GPU. Если наружу не может уходить ничего, берите серверы с GPU, но сначала арендуйте их на месяц нагрузочных тестов.
| Если | Вариант | Железо | Как растёт счёт |
|---|---|---|---|
| Записи у провайдера допустимы, важен срок | Облако | Не нужно | С минутами разговора |
| Данные у вас, API к моделям разрешён | Ваш контур + облачные модели | Обычный сервер без GPU | С минутами, плюс сервер один раз |
| Наружу не уходит ничего | Полностью локально | Серверы с GPU | Один раз под пик, плюс питание и поддержка |
| Не уверены, где должны лежать данные | Облако как пилот | Не нужно | Пилот, потом пересчёт |
Пилот в облаке ничего не теряет: сценарии, знания и интеграции переезжают в контур вместе с вами, меняются только модели под ними.
Кому такое внедрение не подходит?
Если вам нужен робот, который обзванивает базу с одним вопросом, внедрение под ключ - переплата. Для этого есть платформы с поминутным тарифом и конструктором, и их цена честная.
Если вы ещё не можете описать, что робот должен делать на звонке, начинать с цены рано. Цена и срок появляются после спецификации: какие задачи, в каких системах записывать результат, что должно работать при приёмке. Без этого в процессе вылезает тысяча и одна хотелка.
Если звонков мало и нагрузка неровная, покупать железо не стоит даже при строгих требованиях к данным: сначала проверьте, не закрывает ли их средний вариант. Карты, которые простаивают двадцать часов в сутки, - самый дорогой способ хранить записи у себя.
Что ещё войдёт в счёт, кроме сервера?
GPU-сервер для этой работы крутится круглые сутки, потому что круглые сутки работает линия. Значит, нужна стойка с питанием и охлаждением под него, контракт на поддержку, который покрывает карты, а не только шасси, и человек, которому сообщают, когда серверу плохо. Это тот же вопрос, что и кто владеет ассистентом во вторник, только про машину, а не про набор правил.
Связь тоже считается отдельно в любом варианте: SIP-транк, номера, а если звонки идут через мобильную сеть, ещё и два мобильных плеча, которые сжимают голос и добавляют задержку.
Прежде чем считать, послушайте, как робот звучит, в демо, а если вариант понятен, опишите первую поставку на странице Voice AI. Время ответа в демо - та цифра, которую на вашем железе должен побить нагрузочный тест.
Вопросы, которые тут возникают
- Сколько стоит голосовой робот?
- Зависит от варианта поставки. В облаке - поминутная оплата моделей и связи, железо не нужно. Внедрение под ключ мы оцениваем в $25-40 тыс. за первую рабочую версию на 20-30 одновременных разговоров и $1,5-3 тыс. в месяц на сопровождение. Для полностью локального варианта сверху идут серверы с GPU: база на двух L40S - $35-50 тыс. по ценам на 9 октября 2026 года.
- Почему у одних голосовой робот стоит несколько рублей за минуту, а внедрение - десятки тысяч долларов?
- Это разные покупки. Поминутный тариф платформы - доступ к конструктору, где сценарии пишете вы сами. Внедрение под ключ - это телефония, сценарии, интеграции с вашими системами, критерии приёмки и сопровождение. Если вам хватает конструктора, переплачивать за внедрение не нужно.
- Можно ли запустить голосового робота на игровой видеокарте?
- Для демо на столе - да. Для рабочей линии нет: у потребительских карт меньше памяти, нет ECC, охлаждение рассчитано на корпус-башню, а лицензия драйвера GeForce от NVIDIA не разрешает установку в дата-центре.
- Хватит ли сервера без видеокарты?
- Да, если модели работают не на нём. Сервер без GPU - правильная коробка для варианта, где телефония, управление разговором, интеграции и данные у вас, а модели вызываются по API. Распознавание, языковую модель и синтез для нескольких живых звонков одни процессоры быстро не отработают.
- Сколько одновременных звонков выдержит один сервер?
- Наше рабочее допущение - 20-30 разговоров на двух L40S с компактной моделью на 7-14 млрд параметров. Реальное число зависит от моделей распознавания, языка и синтеза и определяется нагрузочным тестом с вашими сценариями до покупки.
- Что дешевле на длинной дистанции: облако или своё железо?
- Считайте по пику и минутам в месяц. При небольшом и неровном потоке облако обычно дешевле, потому что вы не платите за простаивающие карты. Своё железо окупается, когда нагрузка ровная и высокая, или когда данные по требованиям не могут уходить наружу, и тогда вопрос уже не в цене.