Conteúdo9 secções
- O que o preço de um agente de voz inclui de fato?
- Quanto custa um agente de voz na nuvem?
- O que muda no preço se os dados têm de ficar com você?
- Quanto custa o hardware se nada pode sair?
- Por que não economizar no hardware?
- Dá para alugar primeiro e comprar depois?
- Qual opção escolher?
- Para quem esse tipo de implantação não serve?
- O que mais entra na conta além do servidor?
Antes de comprarARTIGO
Quanto custa um agente de voz: nuvem, seu perímetro ou seu próprio hardware
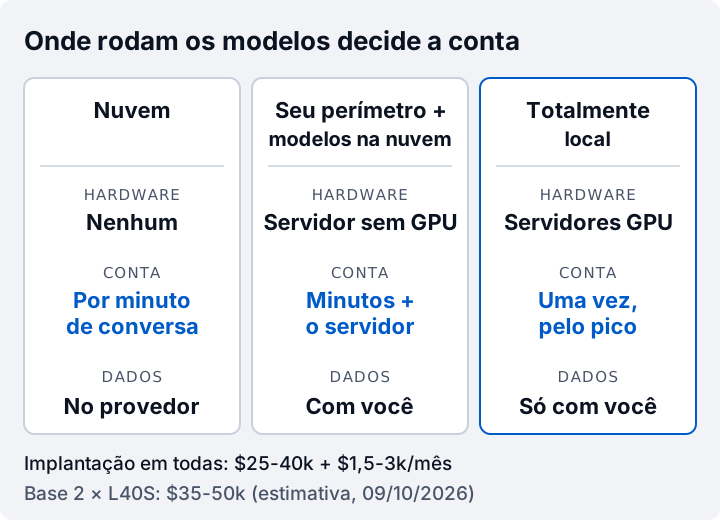
O preço de um agente de voz se forma de jeitos diferentes em cada uma de três opções de entrega: por minuto na nuvem, um servidor comum mais minutos quando os dados ficam com você, e servidores com GPU quando nada pode sair. O orçamento de cada uma, por que hardware barato não dá conta e por que primeiro se aluga e depois se compra.
Costa10 min de leitura
Resposta curta
Quanto custa um agente de voz depende de onde rodam os modelos. Na nuvem você paga por minuto de conversa e não compra hardware. Se os dados têm de ficar com você, entra um servidor comum sem GPU. Se nada pode sair, são precisos servidores com GPU: para 20-30 chamadas simultâneas a base são duas L40S por $35-50k a preços de 9 de outubro de 2026. Estimamos uma primeira versão turnkey em $25-40k mais $1,5-3k por mês de suporte.
Fatos principais
- Atendente de voz turnkey (Asterisk, telefonia, o atendente com IA, integração, lançamento): primeira versão $25-40k, suporte $1,5-3k por mês; hardware, operadora e licenças à parte.
- Preços estimados de servidor em 9 de outubro de 2026: piloto com uma placa $20-35k, base 2 × L40S $35-50k, 2 × RTX PRO 6000 $45-60k, 4 × L40S $55-75k, 4 × H200 NVL $160-200k, A100 80 GB usada $8-12k por placa.
- Alugar 2 × L40S sob demanda, 730 horas por mês, ia de cerca de $790 por mês na Vast.ai a cerca de $2.720 na AWS g6e, com preços verificados em 9 de outubro de 2026.
- O pipeline de voz dos agentes da ElevenLabs custava $0,080 por minuto acima do pacote incluído em 9 de outubro de 2026.
- O número de chamadas por configuração é uma hipótese a confirmar com um teste de carga com os seus cenários, não uma medição.
A pergunta costuma chegar numa linha: quanto custa um agente de voz. As respostas que aparecem são quase sempre a tabela de preços de uma plataforma, tanto por minuto ou um pacote de minutos por trimestre. É um preço honesto, mas de uma compra específica. Na prática, quanto custa um agente de voz se forma a partir de contas diferentes, conforme onde rodam os modelos: por minuto na nuvem, um servidor comum mais minutos quando os dados têm de ficar com você, e servidores com GPU quando nada pode sair. Abaixo está o que calculamos para cada opção, com datas e fontes.
Em resumo: para 20-30 chamadas simultâneas estimamos uma primeira versão turnkey em $25-40k e o suporte em $1,5-3k por mês. Hardware, operadora e licenças ficam à parte, e é no hardware que as opções podem diferir mais do que a implantação inteira.
O que o preço de um agente de voz inclui de fato?
Um agente de voz não é um programa. É uma cadeia que roda em tempo real em cada chamada, e a página de entrega lista os elos: telefonia, reconhecimento de fala, um modelo de linguagem que decide o que dizer, uma voz que diz e as integrações que registram o resultado onde você trabalha com ele.
Alguém paga cada elo. A telefonia é um tronco SIP e números, cobrados pela operadora em todas as opções. Os três modelos do meio são pagos ou por minuto a um provedor ou uma única vez, como o hardware em que vivem. Integrações e cenários são trabalho: um prompt, conhecimento, verificações e testes para cada cenário. E o suporte, porque os cenários mudam com a tabela de preços e a agenda, e alguém precisa ouvir as chamadas.
Por isso, antes de comparar preços vale responder à pergunta que uma tabela por minuto não responde: onde os modelos têm de rodar e onde as gravações têm de ficar.
Quanto custa um agente de voz na nuvem?
A nuvem é a opção em que roda a nossa demo: os modelos ficam com provedores de voz e de modelos de linguagem, não é preciso hardware, o prazo até a primeira versão é o mais curto, e a voz e o tempo de resposta são os que você ouve na chamada.
Você paga por minuto. Como referência pública verificada em 9 de outubro de 2026, o pipeline de voz dos agentes da ElevenLabs custava $0,080 por minuto acima do pacote incluído. A página não diz se o modelo de linguagem entra nessa tarifa, então orce o modelo à parte, assim como a telefonia.
Na nuvem a conta cresce com os minutos, não com o pico. Cem chamadas por dia de três minutos são cerca de 9.000 minutos por mês, e a $0,08 a parte de voz fica em cerca de $720 por mês. É aritmética, não orçamento: ponha os seus minutos e some o modelo e a telefonia.
O que muda no preço se os dados têm de ficar com você?
Aí aparece a opção intermediária: telefonia, controle da conversa, integrações e gravações vivem no seu servidor, e os modelos são chamados por API. O provedor recebe só o necessário para responder, e as gravações, transcrições e fichas de chamada ficam com você.
Essa opção precisa de um servidor comum sem GPU, e os minutos dos modelos são pagos como na nuvem. Voz e tempo de resposta continuam como na demo, porque os modelos são os mesmos. O prazo até a primeira versão é médio: além dos cenários, é preciso implantar e conectar o perímetro do seu lado.
É a resposta mais comum a "os dados ficam conosco", e custa bem menos que a opção totalmente local. Confirme com o seu jurídico se a política permite chamar modelos externos de dentro do perímetro. Se permitir, não há hardware com GPU para comprar.
Quanto custa o hardware se nada pode sair?
A opção totalmente local é a cadeia inteira nos seus servidores. Não há conta por minuto dos modelos, mas há um servidor com GPU, e ele é dimensionado por duas coisas juntas.
Pela memória, porque o reconhecedor, o modelo de linguagem, o sintetizador e o estado de cada conversa em andamento têm de caber nas placas ao mesmo tempo. E pelo momento em que várias pessoas terminam uma frase no mesmo segundo: aí o modelo recebe cinco ou dez pedidos de primeira frase em paralelo, e se a placa está ocupada todos atrasam. O número de chamadas por dia diz quase nada sobre um e outro.
São as configurações da nossa página de entrega, com preços de servidor estimados em 9 de outubro de 2026 a partir de anúncios de placas, memória e chassi. São estimativas, não orçamentos, e a memória subiu muito de preço ao longo de 2026.
| Configuração | Chamadas ao mesmo tempo (hipótese) | Servidor completo |
|---|---|---|
| Piloto: 1 × L40S 48 GB ou 1 × RTX PRO 6000 96 GB | 5-10 / 10-20 | $20-35k |
| Base: 2 × L40S, 32 núcleos, 256 GB, NVMe 2 TB | 20-30 | $35-50k |
| Base com folga: 2 × RTX PRO 6000 96 GB | 30-50 | $45-60k |
| Grande: 4 × L40S ou 4 × H200 NVL | 50-100+ | $55-75k / $160-200k |
| Econômico, usado: A100 80 GB | 15-25 por 2 placas | $8-12k por placa |
A base pressupõe um modelo conversacional compacto de 7-14 bilhões de parâmetros. Um modelo de 30-70 bilhões pede a terceira linha mesmo com o mesmo número de chamadas. A A100 usada é uma opção real para orçamento apertado, com dois custos que vão na mesma linha do preço: sem FP8, e garantia curta ou nenhuma.
Cada número da coluna do meio é uma hipótese. Depende dos modelos que você acabar escolhendo, e antes da compra é substituído por um número medido. Nessa opção a voz e o tempo de resposta também são verificados de novo, porque modelos locais soam e respondem diferente dos da nuvem, e para onde vai o segundo no seu hardware precisa ser medido.
Por que não economizar no hardware?
As três primeiras formas de economizar que vêm à cabeça funcionam em cima da mesa, mas não numa linha.
Uma placa gamer. Num rack ela esbarra em quatro problemas. Menos memória que uma placa de datacenter, então um modelo maior ou mais chamadas não cabem. Sem memória ECC, o que importa numa caixa que roda todos os dias sem ninguém olhando. Refrigeração e alimentação pensadas para um gabinete torre, não para um chassi de servidor denso numa sala que nunca desliga. E a licença: os termos do driver GeForce da NVIDIA não permitem uso em datacenter, e o seu jurídico vai perguntar isso na semana antes de entrar em produção, não na semana antes da compra.
Um servidor sem GPU. Uma boa caixa para a opção intermediária, em que os modelos são chamados por API. Como casa dos próprios modelos é lento demais: uma pausa de três segundos depois de cada frase quebra a conversa mesmo que só duas pessoas estejam ligando.
A menor GPU na nuvem. Alugar uma placa é um jeito sensato de começar um piloto. O erro é tratar o resultado do piloto como o de produção. Uma placa que responde a um testador em menos de um segundo pode responder bem mais tarde a dez pessoas que param de falar juntas, e a diferença só aparece sob carga.
O dinheiro economizado no hardware é gasto depois em chamadas em que o agente fica calado tempo demais. Quem liga não sabe que o servidor está ocupado. Ouve uma pausa e conclui que não foi entendido.
Dá para alugar primeiro e comprar depois?
Dá, e é o que recomendamos. Por 2 × L40S sob demanda, 730 horas por mês, os preços que verificamos em 9 de outubro de 2026 iam de cerca de $790 por mês na Vast.ai, um marketplace de hosts particulares com disponibilidade variável, passando por cerca de $1.150-1.590 na Runpod e cerca de €2.150 na Scaleway, até cerca de $2.720 na AWS, que não tem tamanho de duas placas e vende isso como duas instâncias de uma. A CoreWeave só vende nós de oito placas.
Um mês de aluguel custa uma pequena fração da caixa e compra o único número que importa: como a cadeia se comporta quando chega o seu pico. A ordem que seguimos é curta. Montar a cadeia em placas alugadas. Rodar testes de carga com os seus cenários e o seu pico real. Escrever os requisitos do servidor a partir dos resultados. Comprar depois disso.
Qual opção escolher?
A regra é simples. Se gravações num provedor são aceitáveis, fique com a nuvem: é mais rápida e mais barata para começar. Se os dados têm de ficar com você mas chamar modelos externos por API é permitido, fique com o seu perímetro, modelos na nuvem e um servidor sem GPU. Se nada pode sair, fique com servidores com GPU, mas alugue-os primeiro por um mês de testes de carga.
| Se | Opção | Hardware | Como a conta cresce |
|---|---|---|---|
| Gravações num provedor tudo bem, o prazo importa | Nuvem | Nenhum | Com os minutos de conversa |
| Dados com você, API a modelos permitida | Seu perímetro + modelos na nuvem | Servidor comum sem GPU | Com os minutos, mais o servidor uma vez |
| Nada pode sair | Totalmente local | Servidores com GPU | Uma vez, pelo pico, mais energia e suporte |
| Não está claro onde os dados devem ficar | Nuvem como piloto | Nenhum | Piloto, depois recálculo |
Um piloto na nuvem não perde nada: cenários, conhecimento e integrações se mudam para o perímetro com você, e só os modelos por baixo mudam.
Para quem esse tipo de implantação não serve?
Se você precisa de um agente que ligue para uma lista com uma única pergunta, uma implantação turnkey é pagar demais. Para isso existem plataformas por minuto com construtor, e o preço delas é justo.
Se você ainda não consegue descrever o que o agente deve fazer numa chamada, é cedo para falar de preço. Preço e prazo vêm depois da especificação: quais tarefas, em quais sistemas o resultado é registrado, o que tem de funcionar no aceite. Sem ela, mil e um desejos aparecem pelo caminho.
Se as chamadas são poucas e a carga é irregular, não compre hardware mesmo com requisitos rígidos de dados: veja primeiro se a opção intermediária os cobre. Placas paradas vinte horas por dia são o jeito mais caro de guardar gravações em casa.
O que mais entra na conta além do servidor?
Um servidor com GPU para esse trabalho roda 24 horas, porque a linha também roda. Isso significa um rack com a alimentação e a refrigeração que ele pede, um contrato de suporte que cubra as placas e não só o chassi, e uma pessoa que é avisada quando ele não está bem. É a mesma pergunta de quem é dono do assistente numa terça-feira, feita sobre uma máquina em vez de um conjunto de regras.
A telefonia também fica à parte em todas as opções: tronco SIP, números e, se as chamadas passam por uma rede móvel, os dois trechos móveis que comprimem a voz e somam atraso.
Antes de calcular, ouça como o agente soa na demo e, se a opção estiver clara, descreva uma primeira entrega na página de Voice AI. O tempo de resposta da demo é o número que o seu teste de carga tem de bater no seu próprio hardware.
Perguntas que isto levanta
- Quanto custa um agente de voz com IA?
- Depende da opção de entrega. Na nuvem você paga por minuto os modelos e a telefonia e não precisa de hardware. Estimamos uma primeira versão turnkey para 20-30 chamadas simultâneas em $25-40k, e o suporte em $1,5-3k por mês. Uma instalação totalmente local soma servidores com GPU: a base de duas L40S custa $35-50k a preços de 9 de outubro de 2026.
- Por que uma plataforma cobra centavos por minuto e uma implantação custa dezenas de milhares?
- São compras diferentes. Um plano por minuto de plataforma dá acesso a um construtor em que os cenários são escritos por você. Uma implantação turnkey é telefonia, cenários, integração com os seus sistemas, critérios de aceite e suporte. Se o construtor basta, não há por que pagar uma implantação.
- Dá para rodar um agente de voz numa placa de vídeo gamer?
- Para uma demo em cima da mesa, sim. Para uma linha em produção é a ferramenta errada: placas de consumo têm menos memória, não têm ECC, a refrigeração foi pensada para um gabinete torre e não para um rack, e a licença do driver GeForce da NVIDIA não permite uso em datacenter.
- Um servidor sem GPU basta?
- Sim, se os modelos não estiverem nele. Um servidor sem GPU é a caixa certa para a opção intermediária, em que telefonia, controle da conversa, integrações e dados ficam com você e os modelos são chamados por API. Reconhecimento, modelo de linguagem e síntese para várias chamadas ao vivo só com processadores não respondem rápido o bastante.
- Quantas chamadas simultâneas um servidor aguenta?
- A nossa hipótese de trabalho é 20-30 com duas L40S e um modelo compacto de 7-14 bilhões de parâmetros. O número real depende do reconhecedor, do modelo de linguagem e do sintetizador, e é definido por um teste de carga com os seus cenários antes da compra.