Contenido9 secciones
- ¿Qué incluye de verdad el precio de un agente de voz?
- ¿Cuánto cuesta un agente de voz en la nube?
- ¿Qué cambia en el precio si los datos tienen que quedarse con usted?
- ¿Cuánto cuesta el hardware si no puede salir nada?
- ¿Por qué no ahorrar en el hardware?
- ¿Se puede alquilar primero y comprar después?
- ¿Qué opción elegir?
- ¿Para quién no es este tipo de implementación?
- ¿Qué más entra en la factura además del servidor?
Antes de comprarARTÍCULO
Cuánto cuesta un agente de voz: nube, su perímetro o su propio hardware
El precio de un agente de voz se forma de manera distinta en cada una de tres opciones de entrega: por minuto en la nube, un servidor normal más minutos cuando los datos se quedan con usted, y servidores con GPU cuando no puede salir nada. El presupuesto de cada una, por qué el hardware barato se queda corto y por qué primero se alquila y después se compra.
Costa11 min de lectura
Respuesta corta
Lo que cuesta un agente de voz depende de dónde funcionan los modelos. En la nube paga por minuto de conversación y no compra hardware. Si los datos tienen que quedarse con usted, se añade un servidor normal sin GPU. Si no puede salir nada, hacen falta servidores con GPU: para 20-30 llamadas simultáneas la base son dos L40S por $35-50k a precios del 9 de octubre de 2026. Estimamos una primera versión llave en mano en $25-40k más $1,5-3k al mes de soporte.
Datos clave
- Operador de voz llave en mano (Asterisk, telefonía, el operador con IA, integración, puesta en marcha): primera versión $25-40k, soporte $1,5-3k al mes; hardware, operador de telefonía y licencias aparte.
- Precios estimados de servidor al 9 de octubre de 2026: piloto con una tarjeta $20-35k, base 2 × L40S $35-50k, 2 × RTX PRO 6000 $45-60k, 4 × L40S $55-75k, 4 × H200 NVL $160-200k, A100 80 GB usada $8-12k por tarjeta.
- Alquilar 2 × L40S bajo demanda, 730 horas al mes, iba de unos $790 al mes en Vast.ai a unos $2.720 en AWS g6e, con precios comprobados el 9 de octubre de 2026.
- El pipeline de voz de los agentes de ElevenLabs costaba $0,080 por minuto por encima del paquete incluido el 9 de octubre de 2026.
- El número de llamadas por configuración es una hipótesis que se confirma con una prueba de carga con sus escenarios, no una medición.
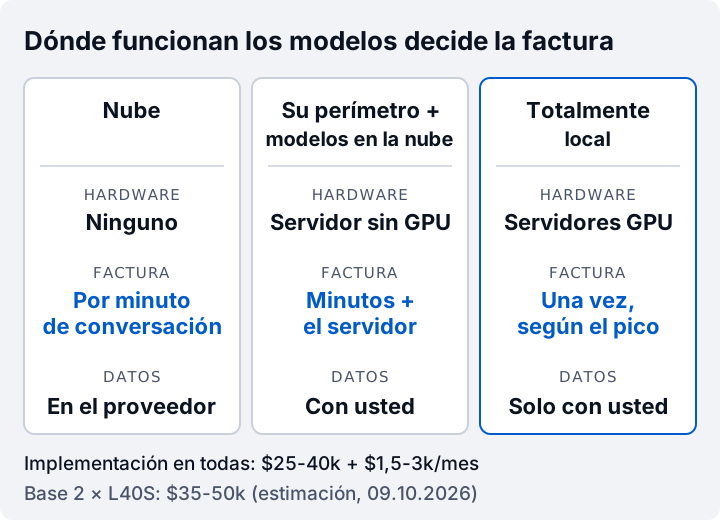
La pregunta suele llegar en una línea: cuánto cuesta un agente de voz. Las respuestas que aparecen son casi siempre la lista de precios de una plataforma, tanto por minuto o un paquete de minutos por trimestre. Es un precio honesto, pero de una compra concreta. En la práctica, lo que cuesta un agente de voz se forma con facturas distintas según dónde funcionen los modelos: por minuto en la nube, un servidor normal más minutos cuando los datos tienen que quedarse con usted, y servidores con GPU cuando no puede salir nada. Abajo está lo que calculamos para cada opción, con fechas y fuentes.
En corto: para 20-30 llamadas simultáneas estimamos una primera versión llave en mano en $25-40k y el soporte en $1,5-3k al mes. El hardware, la telefonía y las licencias van aparte, y es en el hardware donde las opciones pueden diferir más que toda la implementación.
¿Qué incluye de verdad el precio de un agente de voz?
Un agente de voz no es un programa. Es una cadena que funciona en tiempo real en cada llamada, y la página de entrega enumera sus eslabones: telefonía, reconocimiento de voz, un modelo de lenguaje que decide qué decir, una voz que lo dice y las integraciones que dejan el resultado donde usted trabaja con él.
Alguien paga cada eslabón. La telefonía es un troncal SIP y números, facturados por el operador en todas las opciones. Los tres modelos del medio se pagan o por minuto a un proveedor o una sola vez, como el hardware en el que viven. Las integraciones y los escenarios son trabajo: un prompt, conocimiento, comprobaciones y pruebas para cada escenario. Y el soporte, porque los escenarios cambian con la lista de precios y el horario, y alguien tiene que escuchar las llamadas.
Por eso, antes de comparar precios conviene responder a la pregunta que una lista de precios por minuto no responde: dónde tienen que funcionar los modelos y dónde tienen que quedarse las grabaciones.
¿Cuánto cuesta un agente de voz en la nube?
La nube es la opción sobre la que funciona nuestra demo: los modelos están en proveedores de voz y de modelos de lenguaje, no hace falta hardware, el plazo hasta la primera versión es el más corto, y la voz y el tiempo de respuesta son los que oye en la llamada.
Se paga por minuto. Como referencia pública comprobada el 9 de octubre de 2026, el pipeline de voz de los agentes de ElevenLabs costaba $0,080 por minuto por encima del paquete incluido. La página no dice si el modelo de lenguaje entra en esa tarifa, así que presupuéstelo aparte, igual que la telefonía.
En la nube la factura crece con los minutos, no con el pico. Cien llamadas al día de tres minutos son unos 9.000 minutos al mes, y a $0,08 la parte de voz queda en unos $720 al mes. Es aritmética, no un presupuesto: ponga sus minutos y sume el modelo y la telefonía.
¿Qué cambia en el precio si los datos tienen que quedarse con usted?
Entonces aparece la opción intermedia: telefonía, control de la conversación, integraciones y grabaciones viven en su servidor, y los modelos se llaman por API. El proveedor recibe solo lo necesario para responder, y las grabaciones, transcripciones y fichas de llamada se quedan con usted.
Esta opción necesita un servidor normal sin GPU, y los minutos de los modelos se pagan como en la nube. La voz y el tiempo de respuesta siguen como en la demo, porque los modelos son los mismos. El plazo hasta la primera versión es medio: además de los escenarios, hay que desplegar y conectar el perímetro en su lado.
Es la respuesta más habitual a "los datos se quedan con nosotros", y cuesta bastante menos que la opción totalmente local. Compruebe con sus abogados si su política permite llamar a modelos externos desde el perímetro. Si lo permite, no hay hardware con GPU que comprar.
¿Cuánto cuesta el hardware si no puede salir nada?
La opción totalmente local es toda la cadena en sus servidores. No hay factura por minuto de los modelos, pero hay un servidor con GPU, y se dimensiona por dos cosas a la vez.
Por la memoria, porque el reconocedor, el modelo de lenguaje, el sintetizador y el estado de cada conversación en curso tienen que caber en las tarjetas al mismo tiempo. Y por el momento en que varias personas terminan una frase en el mismo segundo: entonces el modelo recibe cinco o diez peticiones de primera frase en paralelo, y si la tarjeta está ocupada todas llegan tarde. El número de llamadas al día no dice casi nada de ninguna de las dos.
Son las configuraciones de nuestra página de entrega, con precios de servidor estimados el 9 de octubre de 2026 a partir de anuncios de tarjetas, memoria y chasis. Son estimaciones, no presupuestos, y la memoria subió mucho de precio durante 2026.
| Configuración | Llamadas a la vez (hipótesis) | Servidor completo |
|---|---|---|
| Piloto: 1 × L40S 48 GB o 1 × RTX PRO 6000 96 GB | 5-10 / 10-20 | $20-35k |
| Base: 2 × L40S, 32 núcleos, 256 GB, NVMe 2 TB | 20-30 | $35-50k |
| Base con margen: 2 × RTX PRO 6000 96 GB | 30-50 | $45-60k |
| Grande: 4 × L40S o 4 × H200 NVL | 50-100+ | $55-75k / $160-200k |
| Económico, usado: A100 80 GB | 15-25 por 2 tarjetas | $8-12k por tarjeta |
La base supone un modelo conversacional compacto de 7-14 mil millones de parámetros. Un modelo de 30-70 mil millones necesita la tercera fila incluso con el mismo número de llamadas. La A100 usada es una opción real con presupuesto ajustado, con dos costes que van en la misma línea que el precio: sin FP8, y garantía corta o ninguna.
Cada número de la columna central es una hipótesis. Depende de los modelos con los que acabe, y antes de comprar se sustituye por un número medido. En esta opción la voz y el tiempo de respuesta también se comprueban de nuevo, porque los modelos locales suenan y responden distinto que los de la nube, y adónde se va el segundo en su hardware hay que medirlo.
¿Por qué no ahorrar en el hardware?
Las tres primeras formas de ahorrar que vienen a la cabeza funcionan sobre la mesa, pero no en una línea.
Una tarjeta gaming. En un rack choca con cuatro problemas. Menos memoria que una tarjeta de centro de datos, así que un modelo mayor o más llamadas no caben. Sin memoria ECC, algo que importa en una caja que funciona todos los días sin que nadie la mire. Refrigeración y alimentación pensadas para una torre, no para un chasis de servidor denso en una sala que nunca se apaga. Y la licencia: las condiciones del driver GeForce de NVIDIA no permiten el despliegue en centros de datos, y su equipo legal lo preguntará la semana antes de la puesta en marcha, no la semana antes de la compra.
Un servidor sin GPU. Una buena caja para la opción intermedia, donde los modelos se llaman por API. Como casa de los propios modelos es demasiado lento: una pausa de tres segundos después de cada frase rompe la conversación aunque solo llamen dos personas.
La GPU en la nube más pequeña. Alquilar una tarjeta es una forma sensata de empezar un piloto. El error es tomar el resultado del piloto como el de producción. Una tarjeta que responde a un tester en menos de un segundo puede responder bastante más tarde a diez personas que dejan de hablar a la vez, y la diferencia solo aparece bajo carga.
El dinero ahorrado en hardware se gasta después en llamadas donde el agente calla demasiado. Quien llama no sabe que el servidor está ocupado. Oye una pausa y decide que no le han entendido.
¿Se puede alquilar primero y comprar después?
Sí, y es lo que recomendamos. Por 2 × L40S bajo demanda, 730 horas al mes, los precios que comprobamos el 9 de octubre de 2026 iban de unos $790 al mes en Vast.ai, un marketplace de hosts particulares con disponibilidad variable, pasando por unos $1.150-1.590 en Runpod y unos 2.150 € en Scaleway, hasta unos $2.720 en AWS, que no tiene tamaño de dos tarjetas y lo vende como dos instancias de una. CoreWeave solo vende nodos de ocho tarjetas.
Un mes de alquiler cuesta una pequeña parte de la caja y compra el único número que importa: cómo se comporta la cadena cuando llega su pico. El orden que seguimos es corto. Montar la cadena en tarjetas alquiladas. Hacer pruebas de carga con sus escenarios y su pico real. Escribir los requisitos del servidor a partir de los resultados. Comprar después.
¿Qué opción elegir?
La regla es sencilla. Si las grabaciones en un proveedor son aceptables, elija la nube: es más rápida y más barata para empezar. Si los datos tienen que quedarse con usted pero se permite llamar a modelos externos por API, elija su propio perímetro con modelos en la nube y un servidor sin GPU. Si no puede salir nada, elija servidores con GPU, pero alquílelos primero un mes para las pruebas de carga.
| Si | Opción | Hardware | Cómo crece la factura |
|---|---|---|---|
| Las grabaciones en un proveedor valen, importa el plazo | Nube | Ninguno | Con los minutos de conversación |
| Los datos con usted, API a modelos permitida | Su perímetro + modelos en la nube | Servidor normal sin GPU | Con los minutos, más el servidor una vez |
| No puede salir nada | Totalmente local | Servidores con GPU | Una vez, según el pico, más energía y soporte |
| No está claro dónde deben quedarse los datos | Nube como piloto | Ninguno | Piloto, luego recálculo |
Un piloto en la nube no pierde nada: escenarios, conocimiento e integraciones se mudan al perímetro con usted, y solo cambian los modelos de debajo.
¿Para quién no es este tipo de implementación?
Si necesita un agente que llame a una lista con una sola pregunta, una implementación llave en mano es pagar de más. Para eso existen plataformas por minuto con constructor, y su precio es justo.
Si todavía no puede describir qué debe hacer el agente en una llamada, es pronto para hablar de precio. El precio y el plazo llegan después de la especificación: qué tareas, en qué sistemas se registra el resultado, qué tiene que funcionar en la aceptación. Sin ella, por el camino aparecen mil y un deseos.
Si las llamadas son pocas y la carga es irregular, no compre hardware aunque los requisitos de datos sean estrictos: compruebe primero si la opción intermedia los cubre. Tarjetas paradas veinte horas al día son la forma más cara de guardar grabaciones en casa.
¿Qué más entra en la factura además del servidor?
Un servidor GPU para este trabajo funciona las 24 horas, porque la línea también. Eso significa un rack con la alimentación y la refrigeración que pide, un contrato de soporte que cubra las tarjetas y no solo el chasis, y una persona a la que se avisa cuando algo va mal. Es la misma pregunta que quién es dueño del asistente un martes, hecha sobre una máquina en lugar de sobre un conjunto de reglas.
La telefonía también va aparte en todas las opciones: troncal SIP, números y, si las llamadas pasan por una red móvil, los dos tramos móviles que comprimen la voz y añaden retardo.
Antes de calcular, escuche cómo suena el agente en la demo y, si la opción está clara, describa una primera entrega en la página de Voice AI. El tiempo de respuesta de la demo es la cifra que su prueba de carga tiene que batir en su propio hardware.
Preguntas que esto plantea
- ¿Cuánto cuesta un agente de voz con IA?
- Depende de la opción de entrega. En la nube paga por minuto los modelos y la telefonía y no necesita hardware. Estimamos una primera versión llave en mano para 20-30 llamadas simultáneas en $25-40k, y el soporte en $1,5-3k al mes. Una instalación totalmente local suma servidores con GPU: la base de dos L40S cuesta $35-50k a precios del 9 de octubre de 2026.
- ¿Por qué una plataforma cobra céntimos por minuto y una implementación cuesta decenas de miles?
- Son compras distintas. Un plan por minuto de una plataforma da acceso a un constructor donde los escenarios los escribe usted. Una implementación llave en mano es telefonía, escenarios, integración con sus sistemas, criterios de aceptación y soporte. Si le basta el constructor, no hay motivo para pagar una implementación.
- ¿Se puede ejecutar un agente de voz en una tarjeta gráfica gaming?
- Para una demo sobre la mesa, sí. Para una línea en producción es la herramienta equivocada: las tarjetas de consumo tienen menos memoria, no tienen ECC, su refrigeración está pensada para una torre y no para un rack, y la licencia del driver GeForce de NVIDIA no permite su despliegue en un centro de datos.
- ¿Basta con un servidor sin GPU?
- Sí, si los modelos no están en él. Un servidor sin GPU es la caja adecuada para la opción intermedia, donde telefonía, control de la conversación, integraciones y datos quedan en su lado y los modelos se llaman por API. Reconocimiento, modelo de lenguaje y síntesis para varias llamadas en vivo solo con procesadores no responden lo bastante rápido.
- ¿Cuántas llamadas simultáneas aguanta un servidor?
- Nuestra hipótesis de trabajo es 20-30 con dos L40S y un modelo compacto de 7-14 mil millones de parámetros. El número real depende del reconocedor, del modelo de lenguaje y del sintetizador, y lo fija una prueba de carga con sus escenarios antes de la compra.